 2026-10-06 05:03:32
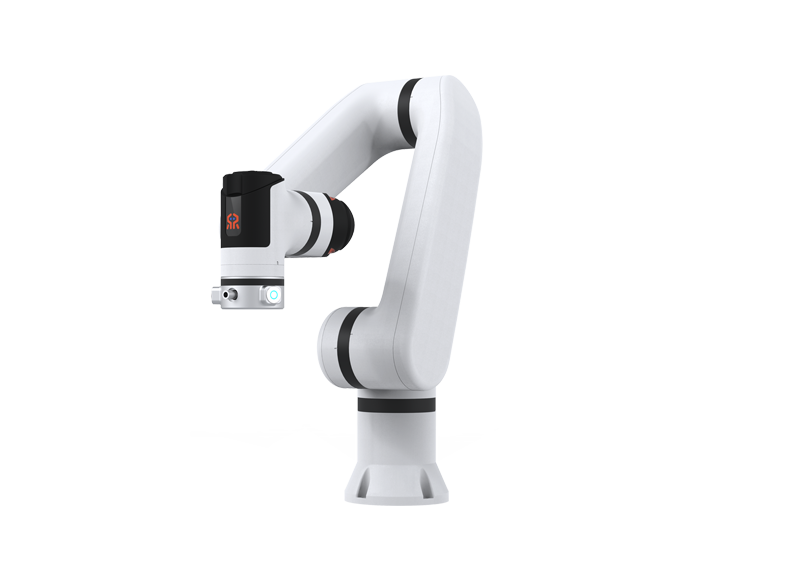
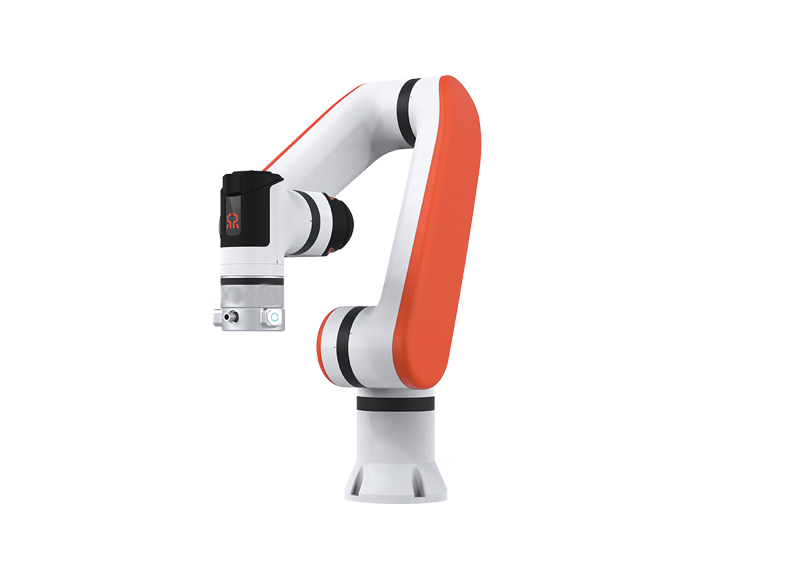
很多人以为机械臂的精度提升仅依赖传感器迭代或算法优化,其实不然。在工业级应用中,当重复定位精度突破±0.02mm阈值后,系统性能的天花板往往由数据质量决定——更准确地说,是可用数据的枯竭速度。某国际汽车零部件供应商的案例极具代表性:其位于德国斯图加特的智能工厂中,六轴机械臂在执行发动机缸体打磨任务时,发现当加工件批次超过5000个后,末端执行器的轨迹补偿模型开始出现振荡,而此时传感器读数仍显示在正常范围内。

听起来可能反直觉,但在高精度场景下,机械臂控制系统面临的是数据熵增与模型泛化能力的矛盾。该供应商的技术团队通过分析发现,当加工件表面微观纹理的统计分布偏离训练集超过18%时,基于高斯过程回归的补偿模型会因输入空间稀疏化而失效。这解释了为何在实验室环境中表现优异的算法,在真实产线中往往在3000-5000次循环后出现性能断崖——不是传感器失效,而是可用数据已耗尽。
案例复盘:2023年F1赛车零部件加工赛中的数据陷阱
在2023年F1英国站零部件加工赛中,某参赛队使用的七轴机械臂在加工前翼导流板时遭遇类似困境。根据赛制规则,所有参赛队需在48小时内完成200个不同曲率的导流板加工,且每个曲率仅允许3次试加工机会。该队采用强化学习算法优化轨迹,初期表现优异,但在第172个工件时,机械臂突然出现0.3mm的定位偏差,直接导致零件报废。
技术复盘显示,问题根源在于赛制设计的“数据陷阱”:强化学习模型在训练阶段使用了5000个模拟数据点,但真实加工中,碳纤维复合材料的各向异性导致实际接触力分布与模拟数据偏差达27%。更关键的是,赛制限制了试加工次数,使得模型无法通过在线学习补充新数据。当加工到第172个工件时,模型输入空间中的有效数据密度已低于临界值,导致决策边界扭曲。
这一案例揭示了机械臂技术的一个深层矛盾:在追求极致精度的道路上,数据获取成本与模型复杂度呈指数级正相关。某头部企业的解决方案颇具启示:他们为产线机械臂配备了“数据健康度监测系统”,通过计算输入数据的KL散度与训练集的差异,当熵值超过阈值时自动触发数据补充流程——不是通过增加传感器,而是通过调整加工参数主动诱导系统产生新数据。这种“数据自愈”机制,正在成为高端制造领域的新标准。
微信公众号

抖音号
视频号
©2025 智能科技(北京)有限公司 版权所有 | 备案:苏ICP备18032181号 | 网站地图






 上一个


